 Agences et studios
 Photographes
 Podcasteurs
 Créateurs vidéo
 Marketeurs et équipes contenu

Il y a deux raisons habituelles. Soit le PDF est un scan, et le « texte » est en réalité une image de texte. Soit le fichier est protégé par un réglage qui bloque la copie. Un scan a besoin d’OCR (reconnaissance de texte) pour transformer l’image en vrai texte. Un fichier protégé doit perdre sa restriction de copie.
Un test rapide vous dit dans quel cas vous êtes.
Quel est votre problème ?
Ouvrez le PDF et essayez deux choses :
- Cliquez et faites glisser sur une ligne de texte. Si rien ne se surligne, ou si toute la page se sélectionne comme une image, le PDF est un scan.
- Si le texte se surligne, essayez de le copier. Si Copier est grisé, ou si rien ne se colle, le fichier est protégé.
La recherche marche aussi : appuyez sur Cmd+F (Ctrl+F sur Windows) et cherchez un mot que vous voyez sur la page. Aucun résultat sur un scan ; des résultats mais pas de copie possible sur un fichier protégé.
Solution 1 : le PDF est un scan, passez-le à l’OCR
Un scanner ou l’appareil photo d’un téléphone enregistre chaque page comme une image. Vous y voyez du texte, mais pour l’ordinateur, ce sont des pixels. L’OCR (reconnaissance optique de caractères) lit ces pixels et ajoute par-dessus la page une couche invisible de vrai texte. La page a exactement le même aspect, mais vous pouvez maintenant sélectionner, copier et rechercher.
Nous avons fait le test sur un contrat d’une page enregistré comme un PDF fait uniquement d’images, comme le ferait un scanner. Avant l’OCR, il ne contenait aucun texte. Après OCR de PDF dans Hangar, ses 201 mots sont tous revenus, noms, sort code (le code bancaire britannique) et numéro de compte compris. La seule erreur : un symbole parasite à l’emplacement de la ligne de signature.
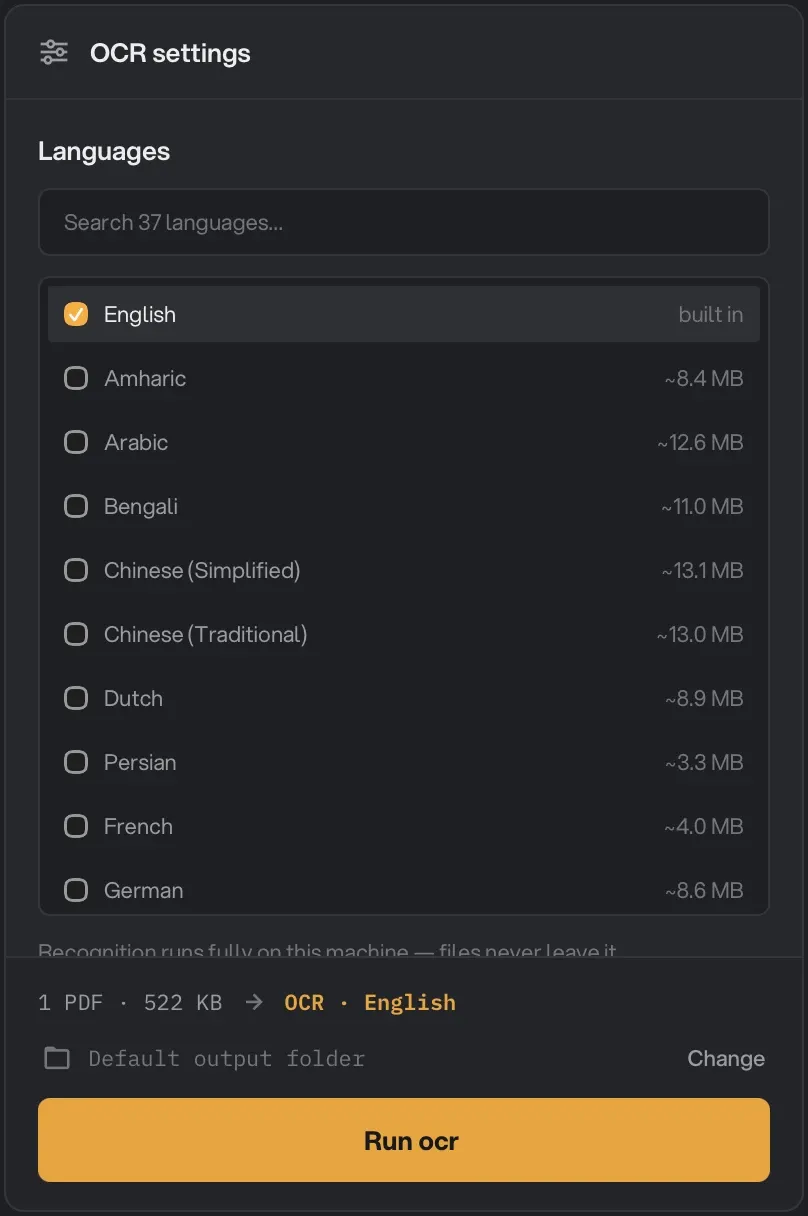
Dans Hangar, l’outil s’appelle OCR PDF :
- Ouvrez OCR PDF et ajoutez votre scan.
- Sous Languages, cochez la langue du document (French pour un document en français). L’anglais est intégré ; les autres langues se téléchargent une fois, la première fois que vous les utilisez.
- Cliquez sur Run ocr. Hangar enregistre une nouvelle copie dont le nom se termine par « -ocr » et ne touche pas à votre scan.
- Ouvrez la nouvelle copie et copiez ce que vous voulez.
Le guide OCR de PDF présente les autres réglages, comme la relecture des pages qui ont déjà du texte.
Voici le haut de notre contrat après l’OCR, à côté du texte que nous en avons copié :
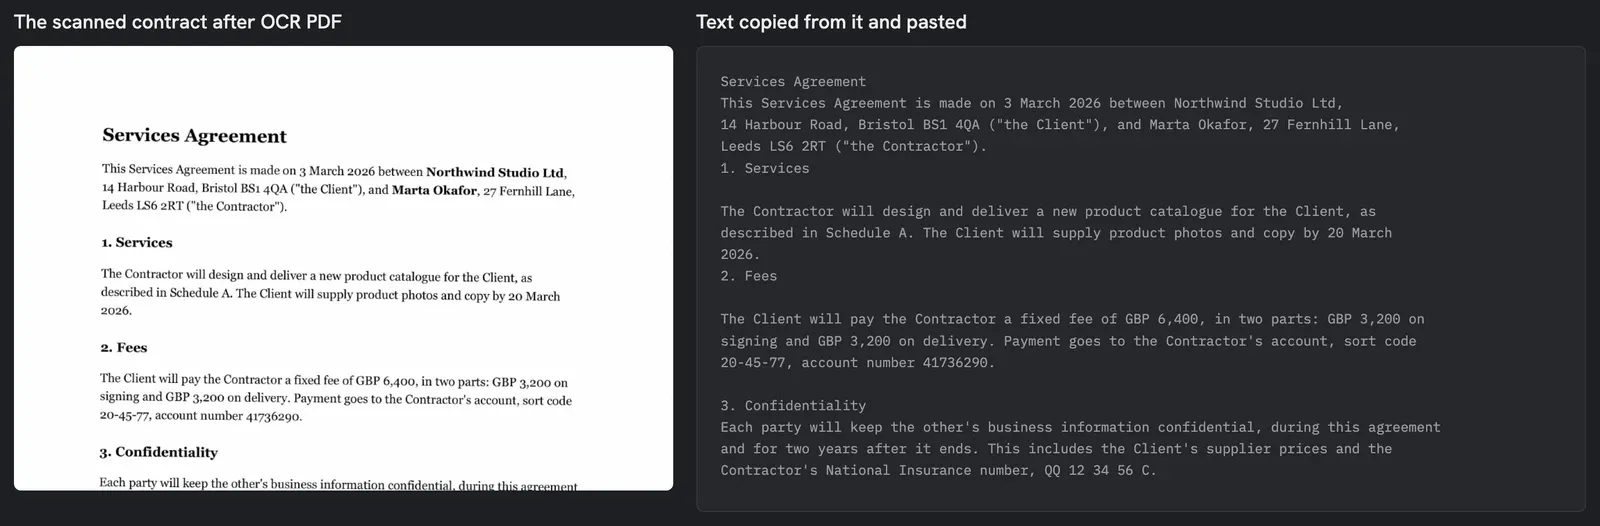
Vérifiez les noms et les numéros après l’OCR. Il est très bon sur un texte imprimé net, moins sûr sur l’écriture manuscrite, les tampons, les photocopies peu contrastées et les polices inhabituelles.
Autres options : Adobe Acrobat Pro intègre l’OCR, avec un abonnement payant. Sur Mac, Texte en direct permet de copier le texte d’une photo ou d’une capture d’écran, morceau par morceau, mais ne rend pas le PDF lui-même cherchable.
Solution 2 : le PDF bloque la copie, déverrouillez-le
Un PDF peut porter un « mot de passe propriétaire » qui fixe ce que le lecteur a le droit de faire : imprimer, copier, modifier. Le fichier s’ouvre normalement, mais la copie est désactivée. Notre contrat de test était réglé pour bloquer la copie et l’impression.
Si le fichier est à vous, ou si vous avez le droit d’en réutiliser le texte, Déverrouiller un PDF retire ces restrictions. Dans l’app, l’outil s’appelle Unlock :
- Ouvrez Unlock et ajoutez le fichier.
- Laissez le champ Password vide. Le champ l’indique lui-même : il ne sert que pour les fichiers qui demandent un mot de passe à l’ouverture.
- Cliquez sur Run unlock. Hangar enregistre une nouvelle copie dont le nom se termine par « -unlocked ».
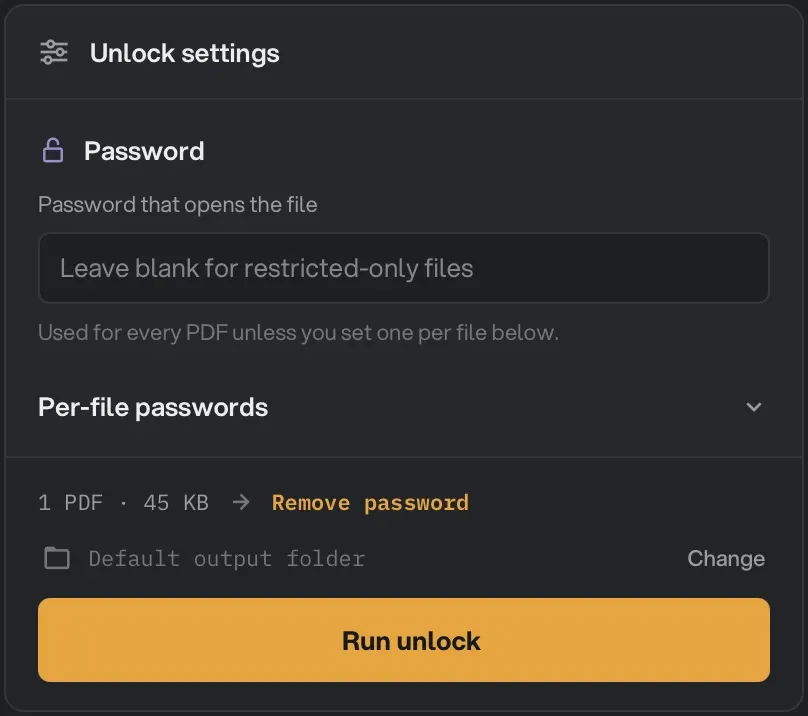
Dans notre test, la copie déverrouillée n’avait plus aucun chiffrement, et la copie comme l’impression étaient de nouveau autorisées.
Un mot sur les droits : les restrictions de copie sont en général là pour une raison. Les retirer ne pose pas de problème sur vos propres documents ou sur ceux que vous avez le droit de réutiliser. Cela ne change rien à qui possède le contenu.
Si le fichier demande un mot de passe pour s’ouvrir, il vous faut ce mot de passe. Tapez-le dans le champ Password, et Unlock enregistre une copie qui s’ouvre sans. Le guide Déverrouiller un PDF indique quels fichiers il peut ouvrir et lesquels il ne peut pas.
Les questions qu’on nous pose
Pourquoi puis-je sélectionner le texte mais pas le copier ?
Le PDF a une restriction de copie. Beaucoup de lecteurs la respectent et grisent Copier. Retirer la restriction avec Déverrouiller un PDF, sur un fichier que vous avez le droit d’utiliser, rétablit la copie.
L’OCR change-t-il l’aspect de mon PDF ?
Non. OCR de PDF ajoute une couche de texte invisible et laisse les images des pages telles quelles. Le fichier grossit un peu, puisque la couche de texte est une donnée de plus.
Peut-on copier le texte d’un PDF scanné sans logiciel ?
En partie. Sur Mac, Texte en direct reconnaît le texte des photos et des captures d’écran, et sur Windows 11, les actions de texte de l’Outil Capture permettent de copier le texte d’une capture. C’est bien pour une ligne ou deux. Pour un document entier que vous voudrez rechercher plus tard, passez-le une fois à l’OCR.
La couche de texte cachée qui permet la copie explique aussi pourquoi un rectangle noir dessiné sur un nom ne le cache pas. Notre guide pour caviarder un PDF correctement montre ce qui se passe.